
前處理產出的乾淨文字,通常仍是以整份文件為單位存在,一份文件可能長達數千字,涵蓋多個主題與段落。若直接將整份文件作為檢索的最小單位,語意會過於龐雜而難以精確比對:使用者的提問通常只針對其中一小段內容,若檢索系統回傳的是整份文件,等於將大量不相關的內容一併夾帶進生成階段。因此,文字必須先被切分為較小的區塊,也就是 Chunking,才能作為後續向量化與檢索的基本單位。
切分的方式大致可分為兩類。固定長度切分依照字數或 token 數為單位機械式地切割文字,實作簡單、速度快,但缺點是切割點可能落在句子中間,導致單一片段語意不完整。語意切分則依照段落、標題、句子邊界等結構性線索進行切割,盡可能讓每個片段保留完整的語意單元,但需要額外的規則或模型來判斷切割點,實作複雜度較高。實務上常見的做法是遞迴切分:優先依照段落等大結構切割,若切出的段落仍超過長度上限,再往下以句子為單位繼續切分,藉此在實作簡便與語意完整之間取得折衷。
切分的粒度會直接影響後續檢索的效果,而這中間存在明顯的取捨。片段切得太小,雖然檢索能精確定位到特定資訊,但單一片段可能因缺乏上下文而語意不完整,也會增加片段總數與計算負擔;片段切得太大,則會混雜多個主題,稀釋掉與查詢真正相關的內容,使檢索出的相似度分數失去鑑別力。為緩解切割邊界造成的語意斷裂,實務上通常會在相鄰片段之間保留一定比例的重疊區間(overlap),確保關鍵資訊不會因為恰好落在切割點而被拆散,但重疊區間設定過大,也會造成儲存與計算成本的浪費。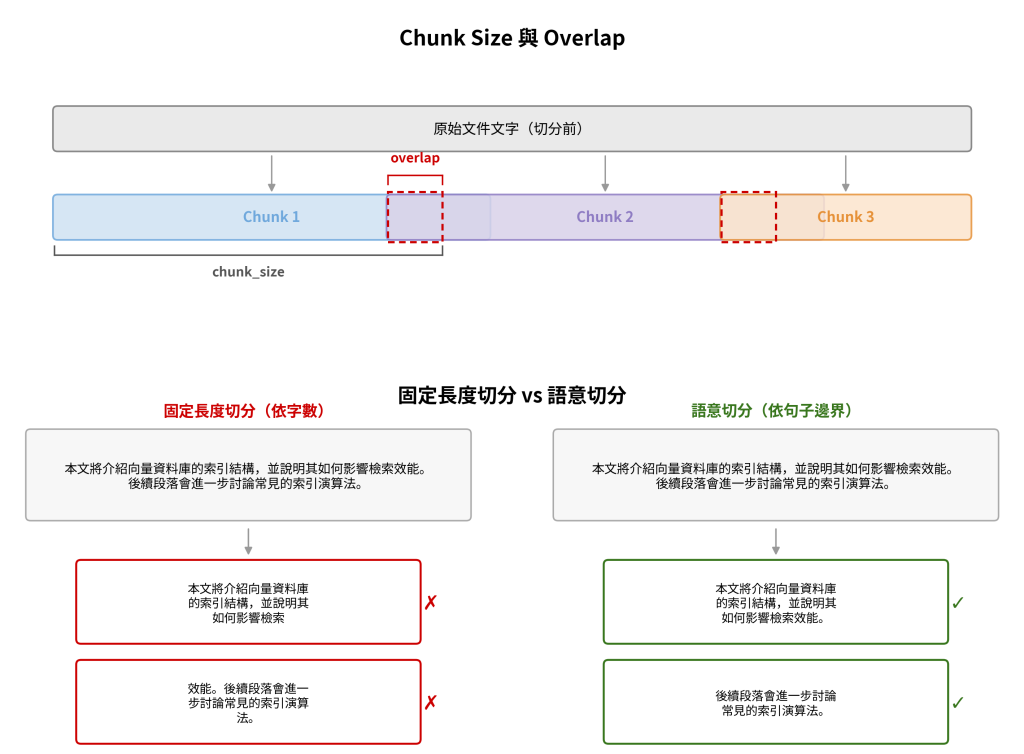
Chunking 的結果,會直接成為下一階段 Embedding 所處理的對象——每個片段的語意是否完整、主題是否單一,會反映在向量表示的品質上,進而影響檢索階段能否準確找到真正相關的內容。換言之,這個階段所做的切分決策,等於預先框定了後續檢索所能達到的精確度上限。


 iThome鐵人賽
 看影片追技術